「AIの修正」に追われる組織を脱却する:修正記憶から「組織の判断力」にするAIOS基盤の設計
サマリー
- AIで時間は節約できている。ただしWorkdayの世界調査(2026年1月、3,200名)によると、AIで生まれた時間の約40%が出力の修正・書き直し・検証で失われている
- 原因はAIの性能不足ではない。組織の経験を構造化して記憶する基盤が存在しないことだ
- 近年各社が競う“AIに修正を記憶させる”メモリ機能は、個人の利便性を高める応急処置。組織知は生成されない
- 国内でも「属人知を組織知に」という動きが広がっているが、その多くは研修で人を変えるか、文書を検索させるかのどちらか。判断力を資産として構造化してはいない
- 根本解決は、判断の勘所を再利用可能な資産へ変換し続ける構造。私たちが開発するAIOS基盤ARIAが目指すもの
- 一次データ(Databricks)では、記憶を構造化すると推論ステップが約20→約5に短縮され、精度は専門家の手動チューニングを上回る。手戻り税は「人の頑張り」でなく構造で消す時代になる
※本稿は2026年9月16日時点で公開された一次情報に基づき執筆しており、最新の動向は随時別記事にてアップデートします。
1. データで見る「AIの生産性パラドックス」
2026年1月14日、Workdayは世界調査レポート「Beyond Productivity: Measuring the Real Value of AI」(Hanover Research実施、2025年11月調査、北米・APAC・EMEAの3,200名)を発表しました。
- 85%の従業員が週1〜7時間の時短を実感している
- しかし約40%の手戻り税――誤りの修正、コンテンツの書き直し、汎用AIツールの出力検証――に失われている
- 一貫して正味のプラスをもたらしている従業員はわずか14%
- 毎日使う層ほど負担は大きく、77%がAIの成果物を人間の成果物と同等以上に精査している
- 修正負担が最も大きい層の約46%は25〜34歳。最もITリテラシーが高いはずの世代が「修正係」になっている
これは一時的な現象ではなく、エージェントが普及するほど大規模化する構造問題です。
2. 原因は「性能不足」ではなく「記憶の構造不在」
なぜ組織の実行力が速くならないのか。理由は3つに分解できます。
- セッションが終われば文脈は消失する。 エージェントの多くは、本番環境の計算リソースの最大85%を「すでに知っていることの再発見」に浪費していると指摘されています
- コンテキストを広げても解決しない。 扱うコンテキストを1M→10Mトークンと10倍に広げると、記憶ベンチマークBEAMのスコアは64.1→48.6へと約25%低下します。窓を大きくしても、窓から覚える仕組みは生まれない
- 組織の判断基準がAIにエンコードされていない。 だから出力が組織の基準に合わず、毎回人が直す。前回の成功パターンを参照できないから、同じ修正を繰り返す
これは「AIの性能不足」ではありません。記憶の構造不在です。
3. 「AIに修正を記憶させる」動きは増えた。ただし根本解決ではない
2025年から2026年にかけて、「記憶」はAI業界の主戦場になりました。ChatGPTとClaudeのパーソナルメモリ、主要なコーディングツールへの指示記憶機能の搭載、Mem0やZepといったメモリ基盤の台頭、国内でもAIエージェントへのメモリ実装が進んでいます。この流れ自体は正しい方向です。
しかし「修正を記憶させる」アプローチには、4つの構造的な限界があります。
(1) 記憶が個人に閉じる――だから組織知にならない
メモリ機能の多くは個人アカウントに紐づきます。2026年7月時点で検証された第三者比較でも、**メモリは個人アカウントに属し、チームの判断が積み上がる共有レイヤーは存在しない――「その人が去れば、その人の文脈も一緒に去る」**と明確に指摘されています。個人の記憶がいくら肥えても、次に入る人はゼロからスタートです。退職とともに消えるものを、組織知とは呼ばない。
「あの人が退職してしまったら困る」という状況は脆い組織です。
(2) 「何を直したか」は残るが「なぜそれが正しいか」が残らない
メモリ機能は、「この表現は変更」「この形式は禁止」といった対処結果(事実)を蓄積するだけです。しかし、「なぜそれがこの組織において正しいのか」という根本的な判断基準や決定プロセスまではAIにエンコード(構造化・ルール化)されません。
そのため同じような例外ケースが次に発生したとき、AIは応用して判断できず、結局人間が再び手直しすることになります。「あれ?これ前も同じことやったな」ということありませんか?
(3) 蓄えるだけだと記憶が陳腐化する
メモリは追加される一方で、重複排除・古い情報の削除・新旧の矛盾解消が行われません。Databricksも「低品質な記憶は間違った教訓を教える」と指摘し、蒸留(distillation)と統合(consolidation)を本番運用の必須要件として挙げています。陳腐化した記憶は新たな手戻りの発生源になります。定期的に人が記憶を整理するというのも本末転倒ですよね。
(4) クラウド上に全員分の文脈を送り直し続けコストがかさんでしまう
メモリをクラウドに置く構造では、利用するたびに全員分の文脈をクラウドLLM(ChatGPT、Gemini、Claude)へ送り直します。単位成果あたりのコストとクラウド依存度は下がらず、使うほど割引かれる構造にはなりません。「使えば使うほどコストが重くなる構造」は、AI活用のスケールにおいて致命的なボトルネックとなります。
修正の記憶は「個人を最適化するパッチ」であり、AIのアウトプットを修正する手戻りは個人を最適化しても消えません。それをなくすには判断力そのものを組織資産として構造化する別の層が必要です。
4. 国内の「組織知」アプローチとの構造的な違い
「属人化した知識を組織知に」は2026年に入り、国内でもこのテーマを掲げる動きが一気に広がりました。その多くは3つのタイプに分かれます。
- 研修・コンサル型: 生成AIを「使える人」を増やし、情報整理の運用を変えることで組織知を整備するアプローチ。人の意識とスキルに寄りかかる。
- 文書RAG型: 社内文書・マニュアル・対応履歴を一元管理し、AIが横断検索するアプローチ。最近はナレッジグラフ併用も増えた。
- 対話アーカイブ型: AI議事録や商談記録が対話を自動蓄積するアプローチ。「話したこと」は残る。
どれも間違ってはいませんが構造として共通する限界があります。知識の入口が「人が書いた文書」か「機械が録った記録」であり、蓄積される単位が「判断」ではないのです。
| 観点 | 研修型 | 文書RAG型 | 対話アーカイブ型 |
|---|---|---|---|
| 知識の入口 | 人の学習と文書化 | 人が作った文書 | 対話の記録 |
| 蓄積の単位 | スキル・ルール | 文書の断片 | 発言の記録 |
| 更新 | 人が続ける | 人が手動更新 | 追記されるのみ |
| 変更管理 | なし | 文書のバージョン管理 | なし |
| 知識の出口 | 人の記憶依存 | 検索回答 | 事例検索 |
研修型は「人が書く・人が覚える」運用に依存し、文書RAG型と対話アーカイブ型は「検索して返す」ことで最終成果としている。しかし手戻りをなくすのに必要なのは検索ではなく次の実行で間違えないことです。判断基準が実行層に接続されていなければ、AIの出力は基準に合わず、人による修正作業は終わりません。
5. 記憶を「構造化」すると、数字は逆転する
Databricksの実験がこの決定的な証拠になっています。
- エージェントに記憶(過去の相互作用とフィードバック)を蓄えていくと、1タスクあたりの推論ステップが約20から約5に短縮された
- 精度は記憶とともに向上し続け、70%まで上昇して、専門家が手で書いたドメインルールやスキーマを約5%上回った
- 注目すべきは、正解ラベルのない生の会話ログ62件を取り込んだだけで、専門家チューニングのベースライン(33.0%)を超えた点です
Databricksはこれを「メモリスケーリング」――モデル強化でも推論強化でもない第3のスケーリングの軸――と定義し、tribal knowledge(属人的な暗黙知)が豊富な企業環境ほど効果が大きいと述べています。前回の成功パターンが次回の推論に使われるとき、手戻りは「人間の頑張り」ではなく構造的に削減されます。
ポイントは、これを個人のアシスタントの中でやるか、組織の基盤としてやるかです。
6. ARIAが組織知を作る設計
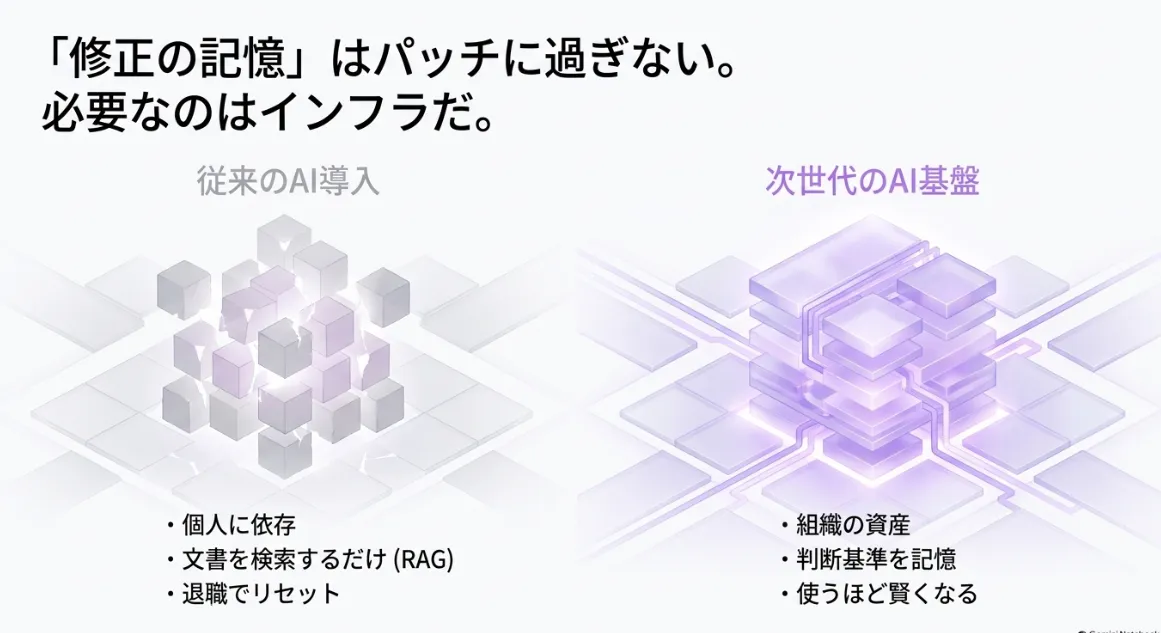
Aezisaiが開発する次世代AIOS(AI Operating System)基盤ARIAは、AIを単なる業務効率化ツールとしてではなく、組織の経験資産を蓄積し、継承し、次の判断に再利用するための認知基盤として設計しています。経験を構造化して記憶する自己学習ループと、P2Pセマンティック交換による分散学習を実装し、属人的に蓄積されがちな判断の勘所を、組織の再利用可能な資産へ変換し続けます。
セクション3で挙げたメモリ機能の4つの限界、コスト増大、セクション4で挙げた国内アプローチの限界。ARIAはこの2つを構造で解くために設計し実装しています。
まとめ:AIを「便利な道具」から「組織のインフラ」へ
私たちが目指しているのは「人間の代わりにチャットを返してくれるAIエージェント」や「自動化されるけど手直しが必要なAI」を作ることではありません。組織の中に蓄積されたノウハウ、成功パターン、ルール、状態の移り変わりなどをすべて安全に保持し、**新しく入ったメンバーでも初日から最高品質で業務をこなせるような「組織の脳となる持続可能なインフラ」**を構築することです。
AIで速くした時間を、AIが出してきたものを修正するための時間に使うのか? 組織の経験を判断力に変換し、毎日少しずつ手戻りを構造的に削減するか? その積み上げが、1年後に圧倒的な競争優位になります。
AIの出力を直すのに結構時間使ってるかも!? と思われた方、その修正コストを課題だと感じていらっしゃる方は、ぜひお話ししましょう。
7. よくある質問(FAQ)
Q. ChatGPTやClaudeのメモリ機能で組織知は作れますか? A. 個人の指示や好みの記憶には有効ですが、スコープは個人です。メンバーの退職とともに文脈は失われ、組織の判断基準はエンコードされません。2026年の第三者比較でも「1人分の記憶」と評価されています。
Q. 社内文書をRAGで検索するのと何が違いますか? A. RAGは文書の断片を検索する仕組みで、「なぜその選択をしたのか」という判断そのものは持ちません。ARIAは判断基準とプロセスを構造化して記憶し、次の推論に再利用します。
出典
- Workday, “Beyond Productivity: Measuring the Real Value of AI”(Hanover Research実施、2025年11月調査・3,200名、2026年1月14日発表) ―― 85%が週1〜7時間時短、約40%が手戻りで消失、正味プラス14%、精査負担77% https://www.prnewswire.com/news-releases/new-workday-research-companies-are-leaving-ai-gains-on-the-table-302660517.html
- Databricks, “Memory Scaling for AI Agents”(2026) ―― 推論ステップ約20→約5、精度70%で専門家ベースラインを約5%上回る、ログ62件で33.0%超え、低品質記憶への警告 https://www.databricks.com/blog/memory-scaling-ai-agents
- Mem0, “State of AI Agent Memory 2026” ―― BEAM(1M→10M)でスコア64.1→48.6(約25%低下) https://mem0.ai/blog/state-of-ai-agent-memory-2026
- MindStudio, “What Is the Agent Memory Problem?”(2026) ―― 本番エージェントの最大85%の計算が既知コンテキストの再発見に消費 https://www.mindstudio.ai/blog/agent-memory-problem-vector-search-not-enough
- METR, “Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity”(2025年7月) ―― RCTで19%遅く(事前予測24%速い/実測後の回答20%速い) https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
- Gartner プレスリリース(2025年8月26日) ―― 2026年末までに業務アプリの最大40%にタスク特化型エージェント https://www.gartner.com/en/newsroom/press-releases/2025-08-26-gartner-predicts-40-percent-of-enterprise-apps-will-feature-task-specific-ai-agents-by-2026-up-from-less-than-5-percent-in-2025
- Harvard Business Review, “AI-Generated ‘Workslop’ Is Destroying Productivity”(2025年9月) ―― MIT Media Lab調査:95%の組織が測定可能なリターンなし https://hbr.org/2025/09/ai-generated-workslop-is-destroying-productivity
- Tana, “Best organizational memory tools in 2026”(2026年7月検証) ―― ChatGPT/Claudeのメモリは個人スコープで組織メモリにならない https://tana.inc/blog/best-organizational-memory-tools-2026
- JAPAN AI, エージェントメモリー実装のお知らせ(2026年3月) ―― 国内エージェントへのメモリ実装の動き https://aismiley.co.jp/ai_news/japan-ai-agent-memory/